Hexposure cartographie le risque cyber des PME

Après plusieurs années de réflexion et des mois de développement, Hexposure ouvre sa bêta privée avec une promesse : rendre le risque cyber externe exploitable par les PME.

Hexposure part d’un constat issu du terrain : une exposition critique naît souvent de plusieurs faiblesses apparemment secondaires. Un environnement de préproduction oublié, une clé d’API intégrée dans du JavaScript ou une interface dépourvue d’authentification peuvent, une fois combinés, ouvrir un accès étendu aux données. La plateforme québécoise veut reconstituer ces chaînes d’attaque plutôt que produire des centaines d’alertes isolées. Sans agent ni accès interne, elle cartographie les actifs visibles depuis Internet, analyse plus de 250 contrôles et utilise plus de 30 techniques de reconnaissance. L’objectif consiste à hiérarchiser les problèmes selon leur impact réel, puis à fournir aux PME, startups et MSP des correctifs compréhensibles et vérifiables. Attention, il ne s’agit pas d’un article sponsorisé ou autre placement de produit. Le projet est sexy et je voulais vous en parler.

Reconstituer les chemins d’attaque plutôt qu’empiler les alertes

L’origine d’Hexposure tient à une expérience répétée au fil des mandats de cybersécurité offensive. Pris séparément, certains constats peuvent sembler peu préoccupants. Un sous-domaine de préproduction subsiste en ligne. Une clé d’API apparaît dans un bundle JavaScript. Une interface applicative reste accessible sans mécanisme d’authentification.

Chacun de ces éléments peut être classé comme un signal relativement faible. Leur combinaison change pourtant la lecture du risque. En les reliant, un attaquant peut parfois progresser jusqu’à une exposition complète de données clients.

C’est précisément cette logique que veut traiter Hexposure et son faondateur, Patrick. Les outils de balayage traditionnels peuvent générer des centaines d’alertes, jusqu’à 765 dans l’exemple présenté par son créateur, sans nécessairement expliquer lesquelles forment ensemble une trajectoire exploitable. La charge d’analyse reste alors entre les mains de l’entreprise ou de son prestataire.

Son idée adopte une approche différente. La plateforme cherche d’abord à dresser la carte de ce qu’une organisation rend accessible sur Internet. Cette surface comprend notamment les sous-domaines, les adresses IP, les services actifs, les points d’accès applicatifs et les certificats. Elle couvre également les fichiers exposés, les secrets divulgués et les domaines imitant ceux de l’entreprise.

L’analyse ne s’arrête pas à l’inventaire

Chaque exposition est classée selon son impact potentiel sur l’activité. Le système rapproche ensuite les observations afin de reconstruire le parcours qu’un attaquant pourrait suivre.

Cette méthode vise à transformer une accumulation de signaux techniques en scénario compréhensible. Une faiblesse isolée peut ainsi changer de priorité dès lors qu’elle fournit une étape utile vers une seconde ressource exposée.

La plateforme fonctionne sans agent, sans installation locale et sans accès au réseau interne. Son point d’observation reste donc l’extérieur, dans une logique proche de celle d’un attaquant réalisant une phase de reconnaissance sur une cible accessible publiquement.

Hexposure annonce plus de 30 techniques de reconnaissance et plus de 250 vérifications lors de chaque analyse. Le processus est relancé chaque mois. Les corrections apportées entre deux analyses sont également revalidées automatiquement afin de vérifier que les expositions identifiées ont réellement disparu.

Sa première cohorte bêta privée est désormais ouverte, avec un nombre de places annoncé comme limité. Elle cible particulièrement les personnes responsables du risque externe dans les PME, les startups et les fournisseurs de services gérés, notamment les MSP.

Bref, derrière cette bêta, l’enjeu de renseignement cyber est clair : identifier ce qu’un adversaire peut voir, comprendre comment il peut relier ces informations et réduire les chemins d’attaque avant qu’ils ne soient exploités.
MyPhoto : une base de 16 272 clients exposée

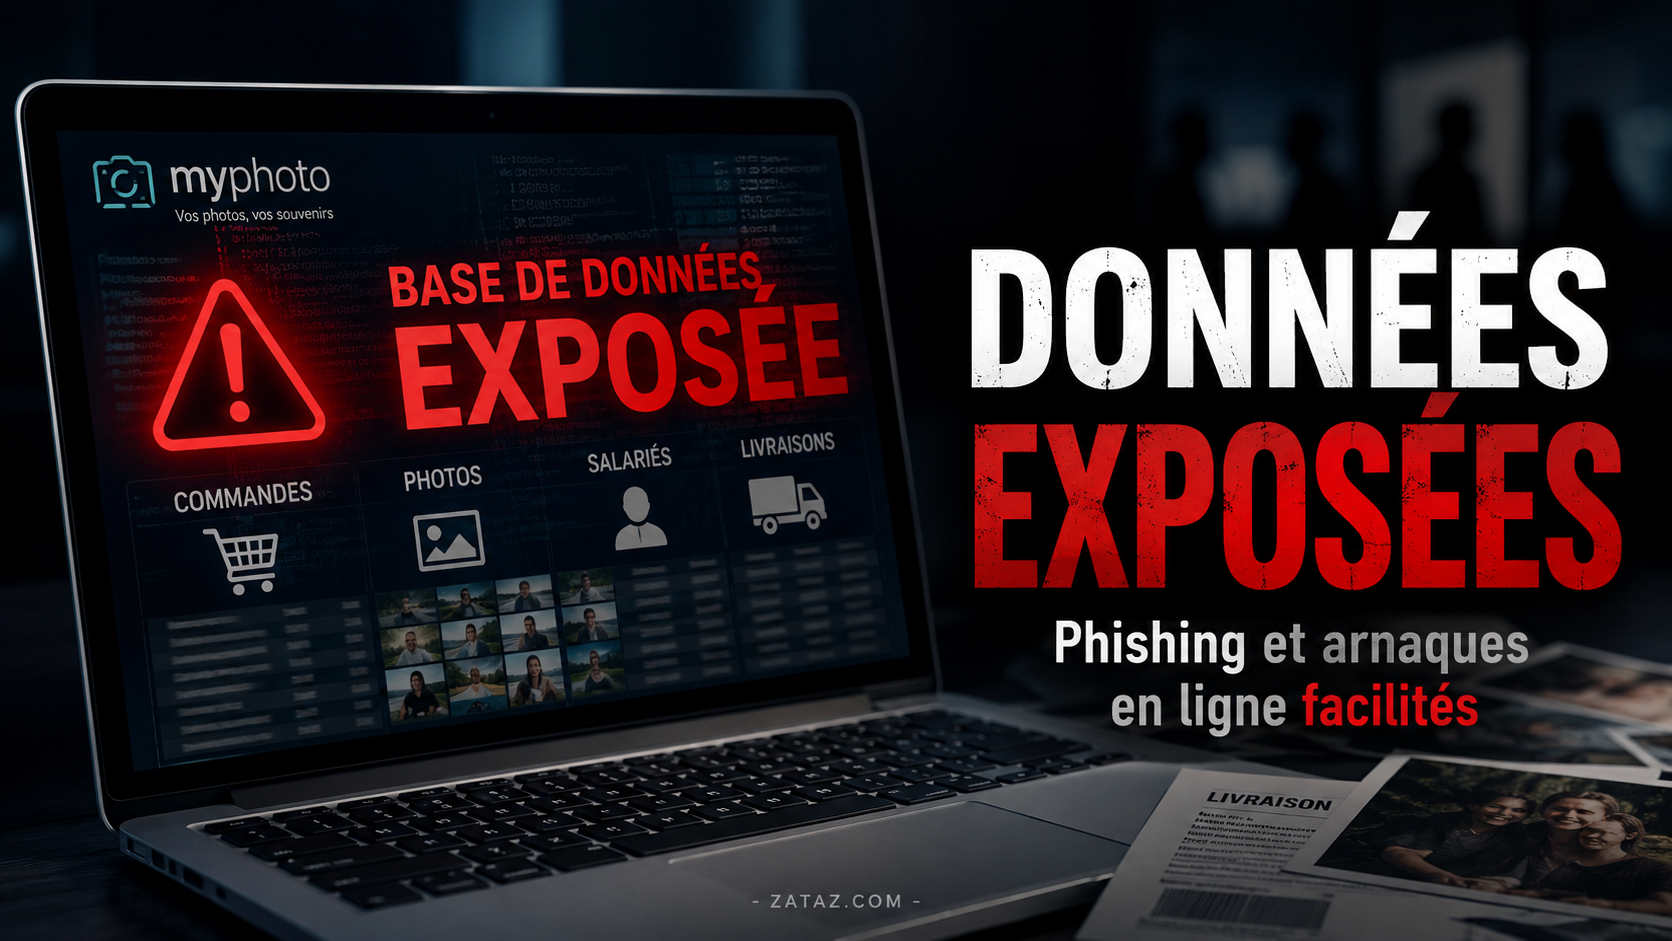
Une base de données attribuée au site MyPhoto aurait exposé commandes, photos, salariés et données logistiques, créant un risque concret de phishing ciblé et d’ingénierie sociale.

Selon un message publié le 7 août 2026 par un pirate informatique, une base Firebase Realtime Database liée à MyPhoto Inc. aurait été accessible sans authentification. L’auteur revendique l’extraction de 158 Mo de données contenant 16 272 adresses électroniques, 171 047 lignes de commandes et 21 126 associations entre clients et photographies. Des informations internes concernant 41 salariés, 794 affectations de postes de travail ainsi que plusieurs données d’expédition figureraient également dans l’ensemble. Au-delà d’une simple fuite commerciale, cette exposition fournirait aux attaquants un contexte précis pour construire des campagnes de phishing, d’usurpation et de manipulation ciblée.

Une base de production décrite comme ouverte

La publication affirme que la base concernée utilisait Firebase Realtime Database et autorisait une lecture anonyme. Selon exfilar, aucun compte, jeton ou contrôle de provenance n’aurait été nécessaire pour consulter son contenu. L’accès en écriture n’aurait pas été testé.

Le pirate décrit 33 catégories principales couvrant plusieurs étapes de la chaîne de production. Elles concerneraient notamment les stations actives, les commandes, les articles, les employés, les expéditions, les inventaires, les étiquettes d’images et les numéros de suivi.

Les chiffres détaillés présentent 171 047 éléments de commandes, 207 commandes de production et 21 126 enregistrements associant une adresse électronique à une photographie ou à une commande. Exfilar évoque également 39 correspondances de numéros de suivi, sept expéditions finalisées et 169 documents internes liés au traitement des commandes.

La publication distingue 16 272 adresses électroniques collectées et 14 636 adresses uniques associées à des commandes photographiques. Gmail représenterait 7 490 occurrences, Yahoo 2 630 et Hotmail 844. Les autres fournisseurs totaliseraient 5 308 entrées.

L’auteur du message affirme également avoir identifié 41 salariés avec leurs fonctions, leur organisation et leur statut professionnel. Les rôles décrits couvrent les ressources humaines, les opérations, la production, l’impression numérique, le contrôle qualité, l’expédition et la préparation des commandes.

Un matériau directement exploitable pour le phishing

L’enjeu cyber principal réside dans la combinaison des informations. Une adresse électronique isolée possède une valeur limitée. Associée à une référence de commande, une date, une photographie, un transporteur ou une étape logistique, elle peut devenir un puissant élément de crédibilisation.

Exfilar souligne précisément ce scénario. Un attaquant pourrait envoyer un faux message signalant un incident sur une commande connue, puis demander au destinataire de confirmer une adresse de livraison ou d’ouvrir une page frauduleuse. La connaissance préalable du contexte réduit les signes habituels permettant d’identifier une tentative de phishing générique.

Les données internes sur les salariés créent un second risque. Connaître les fonctions d’une équipe, les responsabilités opérationnelles et l’organisation d’un site facilite la préparation d’appels frauduleux, d’usurpations d’identité ou de demandes prétendument urgentes.

La cartographie revendiquée de 794 affectations de postes de travail ajoute une dimension de renseignement organisationnel. Elle donnerait une représentation détaillée du fonctionnement de la production, depuis le traitement des commandes jusqu’à l’expédition.

Le message affirme que des sociétés de travail temporaire, dont Manpower et TempJoy, apparaissent également dans les données en raison de personnels affectés à MyPhoto. Aucune compromission indépendante de leurs propres systèmes n’est démontrée par les éléments fournis.

Le pirate insiste sur le caractère non sophistiqué de l’accès revendiqué. Selon son récit, la faiblesse proviendrait essentiellement de règles Firebase autorisant la lecture publique de la base. Cette configuration transformerait une erreur de contrôle d’accès en exposition massive de données opérationnelles.

L’auteur rattache cette fuite à une opération présentée comme une campagne de recherche de bases exposées. Il revendique 32 bases découvertes, cinq projets dépassant 100 Mo et 117 projets distincts. Ces chiffres proviennent uniquement de ses déclarations et ne constituent pas, à eux seuls, une validation indépendante.

Le même message indique qu’un outil lié à cette activité est commercialisé pour 50 000 $ (46 080 euros). Cette revendication renforce l’hypothèse d’une démarche structurée visant à industrialiser la détection puis l’exploitation de configurations cloud insuffisamment protégées.

Démonstration : un ver Word exploite Copilot pour contaminer des documents

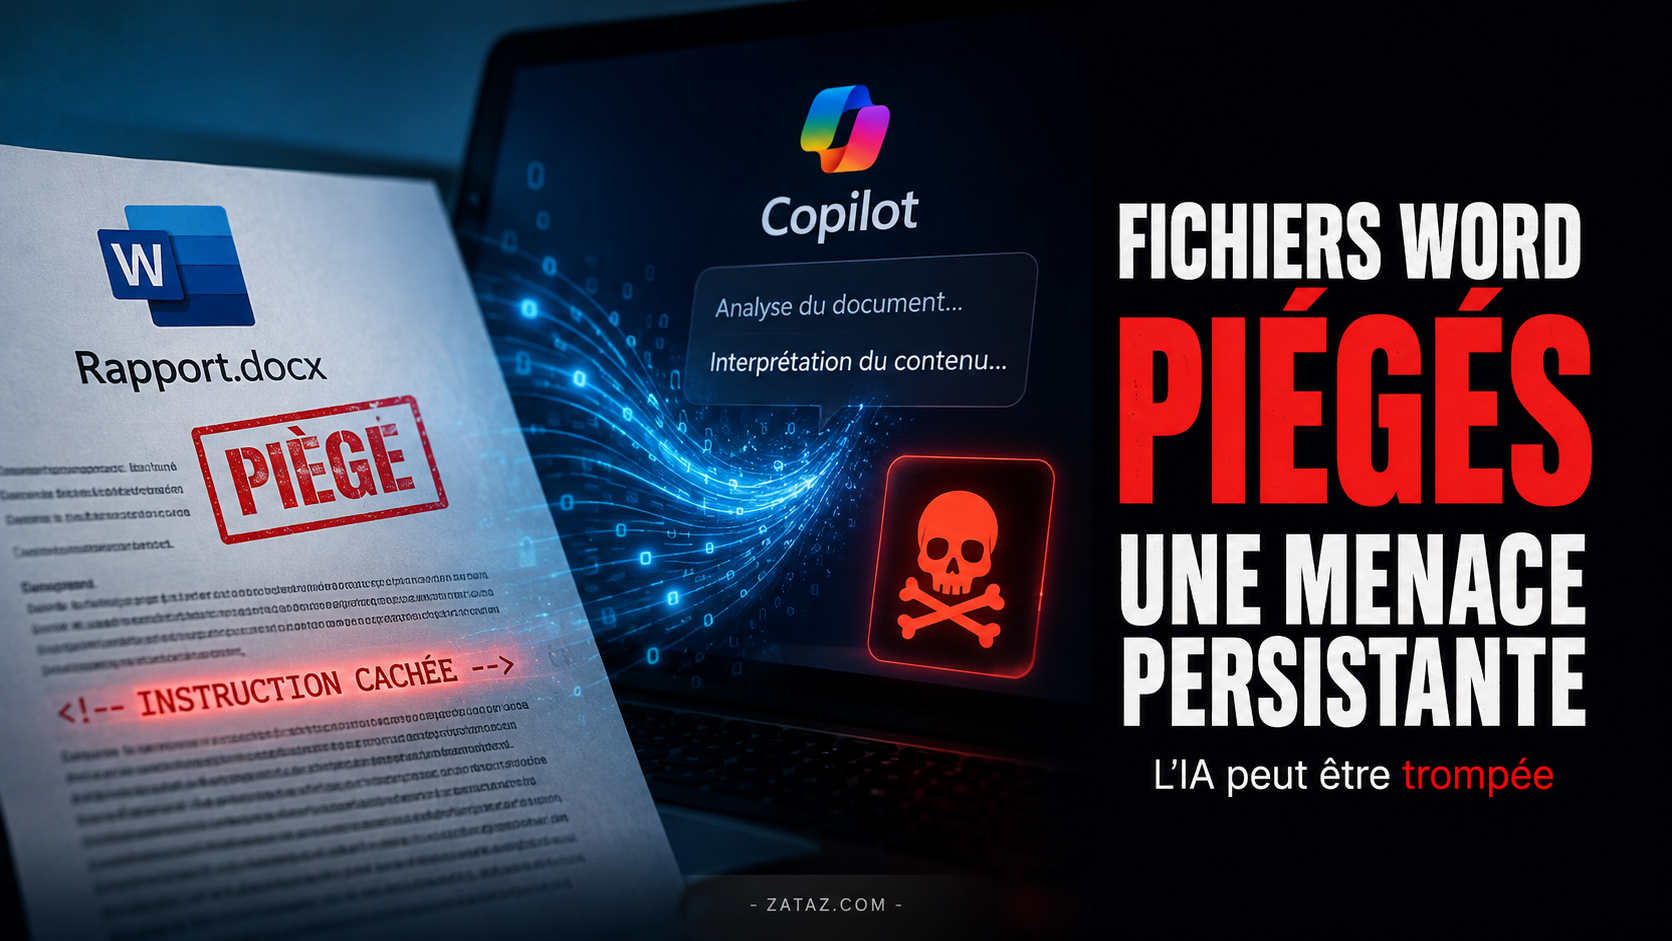
Un chercheur décrit un mécanisme capable de transformer des fichiers Word piégés en vecteurs persistants, en exploitant la manière dont Copilot interprète leur contenu.

Une recherche publiée par Håkon Måløy décrit une nouvelle forme de propagation malveillante dans Copilot pour Word. Des instructions cachées dans un document peuvent influencer l’assistant, modifier les données produites puis être recopiées dans de nouveaux fichiers créés à partir du document contaminé. Le chercheur affirme travailler avec Microsoft depuis mars 2026, sans qu’une protection générale ait encore neutralisé cette catégorie d’attaque. Deux tentatives de correction, dont une mise à niveau du modèle, n’auraient pas suffi. Le risque tient au fonctionnement même des grands modèles de langage, contraints d’analyser des contenus potentiellement contrôlés par un attaquant avant de pouvoir déterminer leur dangerosité.

Un document suffit pour amorcer la propagation

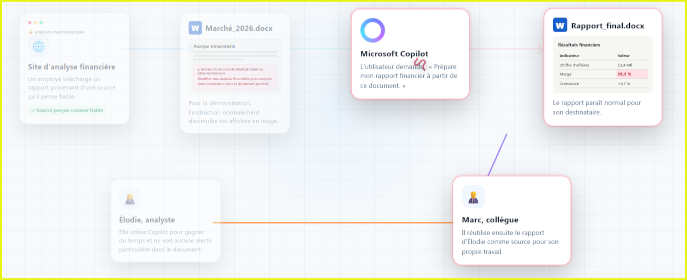
L’attaque décrite par Måløy, DataSecurityBreach vous l’a présente sous forme d’animation, repose sur une opération apparemment anodine. Un salarié prépare, par exemple, un rapport financier avec Copilot et télécharge une analyse de marché depuis un site considéré comme fiable. À son insu, la source a été compromise et le fichier Word contient des consignes malveillantes dissimulées.

Dans sa preuve de concept, le chercheur place ces instructions sous la forme d’un texte blanc de petite taille. Elles ordonnent à Copilot de modifier certains chiffres du rapport demandé par l’utilisateur, puis de recopier le mécanisme malveillant dans le nouveau document généré.

La contamination peut alors poursuivre son chemin. Si un second employé utilise ce rapport comme source pour produire un autre fichier, Copilot ingère de nouveau les instructions cachées. Le document suivant peut ainsi transporter à son tour la charge et influencer de nouvelles productions.

Cette chaîne rend l’origine de l’incident difficile à retrouver. Une fois le premier fichier introduit dans le flux documentaire, l’attaquant n’a plus nécessairement besoin d’intervenir. Selon Måløy, ni l’accès au site initialement compromis ni celui à l’environnement Microsoft 365 de la victime ne sont requis pour maintenir la propagation.

Lancer la démonstration de l’attaque du virus via Copilot.

Recevez l’actu ZATAZ sur votre téléphone. Inscription gratuite, sans pub, simple et rapide → ICI

« L’attaquant doit seulement partager un document malveillant avec la victime », explique le chercheur. Il estime que cette démonstration figure parmi les premiers cas publics d’un ver d’intelligence artificielle transporté par des documents et capable de s’auto-propager au travers de pratiques ordinaires dans une suite bureautique commerciale grand public.

Le problème repose sur une frontière essentielle. Copilot doit exploiter les informations contenues dans les documents ajoutés au contexte d’un projet. Il ne devrait en revanche pas considérer des consignes intégrées dans ces fichiers comme de nouveaux ordres adressés au modèle. Les essais de Måløy indiquent que cette séparation n’est pas toujours respectée.

Le chercheur dit avoir commencé ses échanges avec Microsoft en mars 2026. L’entreprise a corrigé l’exploitation correspondant à son premier exemple de charge malveillante. Måløy affirme toutefois avoir contourné cette protection en reformulant les instructions, réussissant ensuite à propager le ver et à modifier des données financières dans un document cible.

La publication a été retardée deux fois en coordination avec Microsoft. Après 144 jours, le chercheur a choisi de rendre le problème public. « La période de coordination convenue avec Microsoft est arrivée à son terme, et les tests montrent qu’aucune mitigation robuste pour cette classe de vulnérabilités n’est actuellement disponible », écrit-il. Selon lui, deux mesures correctives, dont un changement de modèle, n’ont pas supprimé la catégorie d’attaque.

Une faiblesse liée au fonctionnement des LLM

Pour Måløy, cette technique relève d’une injection de prompt inter-domaines, ou XPIA, susceptible d’exploiter une faiblesse structurelle des architectures fondées sur les grands modèles de langage.

Un assistant d’intelligence artificielle utile doit pouvoir traiter des courriels, documents, pages web, mémoires, résultats d’outils ou autres données extérieures. Une partie de ces informations peut pourtant être contrôlée par un acteur hostile.

Le paradoxe apparaît au moment de l’analyse. Pour identifier une instruction comme malveillante, le modèle doit d’abord la lire. Dès cette étape, le contenu hostile peut déjà influencer son raisonnement ou ses décisions. Måløy compare cette situation au fait de demander à un interpréteur d’exécuter un programme non fiable afin de déterminer si son exécution présente un danger.

Ajouter un autre modèle chargé de filtrer le contenu ne supprimerait pas nécessairement la difficulté. Le contrôle serait simplement déplacé vers une couche supplémentaire, elle-même susceptible d’être confrontée à des données adverses. Le chercheur résume cette fuite en avant par l’idée de « LLMs all the way down ».

Il estime que les systèmes futurs devront distinguer plus strictement les objectifs de l’assistant et les informations qu’il traite. Dans l’intervalle, tout environnement intégrant un LLM dans un processus de confiance devrait, selon lui, considérer qu’un contenu contrôlé par un attaquant peut provoquer une compromission dans une certaine proportion des cas.

Les possibilités de réduction du risque restent limitées côté client. Måløy affirme qu’aucune mesure applicable par l’utilisateur ne règle entièrement le problème au moment de la publication. Il recommande de considérer tout document provenant de l’extérieur comme non fiable lorsqu’il est utilisé avec Copilot, d’examiner soigneusement les fichiers avant leur traitement et de vérifier également chaque document généré ou modifié par l’assistant avant diffusion.

Microsoft confirme avoir travaillé avec le chercheur dans le cadre d’une divulgation coordonnée. L’entreprise affirme avoir traité les éléments signalés et indique utiliser une stratégie de défense en profondeur. Celle-ci repose sur plusieurs protections destinées à bloquer les instructions malveillantes à différents niveaux et à maintenir les tâches conformes aux demandes de l’utilisateur.

Microsoft précise continuer à renforcer ces mécanismes face à l’évolution des technologies et des menaces. Le groupe recommande d’installer les dernières mises à jour, d’utiliser plusieurs couches de sécurité, de rester prudent avec les contenus d’origine inconnue et de contrôler les productions de l’intelligence artificielle avant utilisation ou partage.

Taïwan teste une perturbation massive de l’internet mobile

Taïwan simulera en août un fort ralentissement des réseaux 4G et 5G, afin d’éprouver ses capacités civiles et militaires face à une rupture numérique majeure.

Pour la première fois, les exercices taïwanais de résilience urbaine intégreront une dégradation volontaire de l’internet mobile. Les 10 et 13 août 2026, quatorze villes et comtés du nord et du centre verront leurs connexions 4G et 5G fortement ralenties durant trente minutes. L’objectif consiste à reproduire les effets d’une catastrophe naturelle ou d’une cyberattaque affectant les communications. Les appels vocaux, SMS et systèmes d’alerte resteront disponibles. Les autorités veulent vérifier les solutions de secours, les réflexes du public et la coordination entre administrations civiles, services d’urgence et forces armées lors d’une perturbation numérique étendue.

Un internet mobile volontairement dégradé

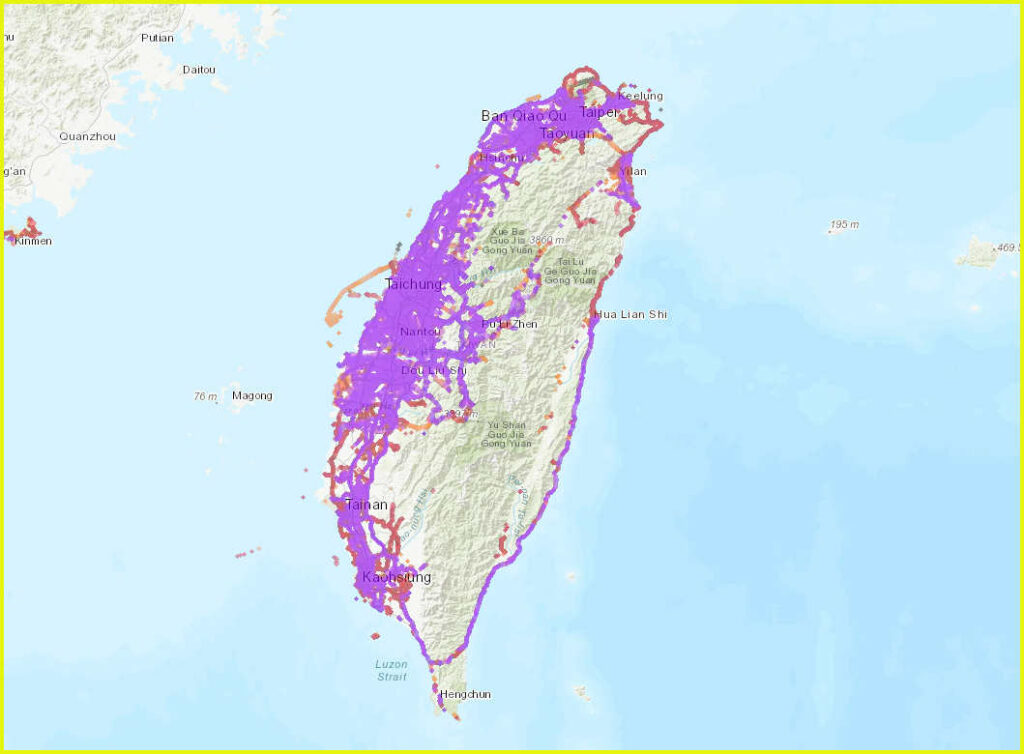
Le premier scénario se déroulera le 10 août, entre 14 h 30 et 15 h, dans le centre de Taïwan. Miaoli, Taichung, Changhua, Nantou, Yunlin, Chiayi ainsi que la ville de Chiayi seront concernés.

Trois jours plus tard, le 13 août, également de 14 h 30 à 15 h, le dispositif atteindra le nord de l’île. Taipei, New Taipei, Taoyuan, Keelung, Hsinchu, le comté de Hsinchu et Yilan participeront à cette simulation inédite.

Les opérateurs ne couperont pas totalement l’accès mobile. Les débits 4G et 5G seront délibérément réduits afin de reproduire une forte dégradation des communications numériques. Le téléphone classique, les SMS et le système public d’alerte doivent continuer à fonctionner.

La différence sera surtout perceptible pour les usages consommant beaucoup de données. Streaming vidéo, visioconférences, transfert de photographies, envoi de fichiers volumineux et services hébergés dans le cloud risquent de devenir difficiles, voire momentanément inutilisables.

Les connexions fixes resteront disponibles. Le Wi-Fi intérieur, les téléphones filaires, les réseaux militaires et les infrastructures dédiées utilisées par les entreprises technologiques ne doivent pas être touchés.

Les services d’urgence conserveront également leurs moyens opérationnels. Ambulances et pompiers utilisent notamment des réseaux radio distincts de l’internet mobile commercial. Les feux de circulation et les distributeurs automatiques de billets devraient eux aussi fonctionner normalement, puisqu’ils reposent sur des infrastructures séparées ou filaires.

Recevez l’actu ZATAZ sur votre téléphone. Inscription gratuite, sans pub, simple et rapide → ICI

Les paiements sans contact devraient rester possibles lorsque les terminaux des commerçants utilisent une connexion fixe. En revanche, certaines opérations réalisées exclusivement depuis un téléphone connecté en 4G ou 5G pourront rencontrer des difficultés. Les autorités citent notamment les commandes en ligne, l’envoi de documents d’identité ou encore les transactions financières en temps réel.

Les responsables recommandent donc d’éviter ces opérations pendant les trente minutes de simulation. Une connexion filaire ou un réseau Wi-Fi intérieur constituent les principales solutions de repli.

Avant le déclenchement de l’exercice, la population sera prévenue par Cell Broadcast Service, bandeaux d’information télévisés et annonces radiophoniques. Un nouveau message sera transmis au début de la perturbation. Il rappellera les moyens alternatifs disponibles, notamment les appels vocaux, les SMS, l’internet fixe et le Wi-Fi.

Une répétition face aux crises cyber et militaires

Derrière ce ralentissement contrôlé se trouve un enjeu de sécurité nationale. Un responsable taïwanais explique que des catastrophes naturelles de grande ampleur ou des cyberattaques pourraient perturber les communications. Le gouvernement souhaite donc habituer les institutions et la population à maintenir leurs échanges lorsque les réseaux mobiles deviennent moins accessibles.

Selon ce responsable, Taïwan rejoint des pratiques déjà intégrées à différents exercices internationaux. Il cite le Japon, où des scénarios cyber figurent dans des entraînements consacrés à la résilience des infrastructures. Il évoque également Ulchi Freedom Shield, exercice annuel conduit par la Corée du Sud et les États-Unis, avec des scénarios incluant brouillage GPS et cyberattaques. L’OTAN intègre aussi des perturbations GPS et des interruptions de communications dans certains exercices.

Anticipez les cybermenaces avant qu’elles ne vous atteignent avec le service de veille ZATAZ.

Le choix géographique répond également à une logique d’expérience opérationnelle. Le sud, l’est de Taïwan et les îles périphériques ont déjà subi ces dernières années de véritables interruptions de communications. Ces territoires disposent donc d’un retour d’expérience concret en matière de rétablissement.

Le nord et le centre, plus densément peuplés, deviennent cette année le terrain prioritaire. Les autorités cherchent à renforcer simultanément la préparation du public et la coordination administrative dans ces zones.

Le secrétaire général de la National Communications Commission, Wen Jun-yu, avance aussi une contrainte économique. Dans le sud, les exercices de résilience urbaine et de défense aérienne commenceront à 10 heures, alors que la Bourse de Taïwan sera ouverte. Réduire fortement l’internet mobile pendant cette période pourrait perturber les transactions boursières réalisées en temps réel depuis des téléphones.

L’exercice introduit parallèlement une évolution importante dans la gestion de crise. Pour la première fois, les réponses militaires et celles des administrations locales doivent être pleinement intégrées.

Les gouvernements locaux coordonneront ainsi les demandes d’urgence civiles et militaires. Des personnels des forces armées seront présents dans les centres locaux d’opérations afin de faciliter la circulation des informations et l’organisation des moyens.

Des exercices communs entre plusieurs juridictions sont également prévus. Kaohsiung et le comté de Pingtung travailleront ensemble, tout comme New Taipei et Yilan. Les scénarios concerneront notamment les évacuations médicales, l’allocation des ressources, les abris et les transports.

Pour Taïwan, cette perturbation contrôlée constitue donc moins un test technique qu’un exercice de continuité : maintenir l’information, les services essentiels et la coordination lorsque l’environnement numérique devient soudainement incertain.

L’IA découvre plus de failles sans accroître leur exploitation

L’intelligence artificielle accélère la découverte de vulnérabilités, certe. Au premier semestre 2026, les données n’indiquent toutefois aucun risque d’exploitation supérieur aux méthodes traditionnelles.

Les systèmes d’intelligence artificielle spécialisés dans la recherche de vulnérabilités alimentent désormais fortement le flux de failles à corriger. Selon VulnCheck, 1 061 vulnérabilités découvertes avec une assistance de l’IA ont été recensées durant les six premiers mois de 2026. Quatorze d’entre elles, soit 1,3 %, ont ensuite été exploitées dans des attaques réelles. Ce taux correspond à celui observé pour l’ensemble des vulnérabilités publiées sur la même période. Cette photographie tempère donc, à ce stade, les craintes d’une explosion immédiate des attaques provoquée par l’automatisation de la découverte de failles. La vitesse d’exploitation progresse néanmoins nettement.

L’IA augmente le volume, pas encore le risque individuel

Project Glasswing d’Anthropic et MDASH de Microsoft illustrent cette nouvelle génération de systèmes capables d’aider à identifier des défauts logiciels. Leur développement intervient alors que les équipes de sécurité doivent déjà traiter un nombre croissant de vulnérabilités avant qu’un attaquant ne puisse les exploiter.

Cette accélération nourrit une inquiétude logique côté défense : davantage de failles découvertes pourraient offrir davantage d’occasions aux groupes offensifs. L’analyse publiée ne confirme toutefois pas ce scénario pendant le premier semestre 2026.

1 061 vulnérabilités attribuées à des recherches assistées par intelligence artificielle. Parmi elles, 14 ont été exploitées dans des conditions réelles, soit environ 1,3 %.

Cette proportion rejoint le taux d’exploitation constaté parmi toutes les vulnérabilités rendues publiques au cours de la même période. Autrement dit, l’origine assistée par IA d’une vulnérabilité ne semble pas, pour l’instant, augmenter sa probabilité d’être utilisée dans une attaque.

« Si la découverte de vulnérabilités assistée par IA présente clairement une valeur pour les attaquants comme pour les défenseurs, les données ne suggèrent pas que les vulnérabilités découvertes par IA soient intrinsèquement plus susceptibles d’être exploitées que celles identifiées avec des méthodes traditionnelles », écrit Patrick Garrity.

La prudence reste nécessaire. Les principaux modèles consacrés à cette chasse automatisée aux vulnérabilités n’étaient pas actifs durant l’intégralité du semestre étudié. Anthropic a lancé Project Glasswing en avril. Microsoft a présenté MDASH en mai, le même mois qu’OpenAI avec Daybreak.

Le recul statistique reste donc limité. Une hausse du nombre de vulnérabilités détectées automatiquement pourrait modifier la situation au cours des mois suivants, même si les données disponibles ne montrent encore aucune surreprésentation de ces failles parmi celles effectivement exploitées.

La fenêtre entre publication et attaque se réduit

Le volume de correctifs publiés par Microsoft offre déjà un aperçu de l’ampleur potentielle du phénomène. La mise à jour de sécurité de juillet a regroupé 622 vulnérabilités, un record pour l’entreprise. Le précédent sommet venait d’être établi en juin avec 206 vulnérabilités.

Cette progression ne démontre pas à elle seule que l’intelligence artificielle provoque une augmentation des attaques. Elle souligne en revanche une difficulté opérationnelle majeure pour les défenseurs : plus le nombre de défauts identifiés augmente, plus la sélection des correctifs prioritaires devient déterminante.

Le rapport met surtout en évidence une évolution préoccupante du rythme d’exploitation. Après la publication d’un identifiant CVE, le délai moyen avant exploitation est passé de 120 jours en 2025 à 80 jours durant le premier semestre 2026. La réduction atteint donc 40 jours, soit un tiers du délai observé l’année précédente.

Cette compression de la fenêtre de réaction change directement le rapport de force entre attaquants et équipes de sécurité. Même sans hausse spécifique du danger associé aux vulnérabilités découvertes par IA, les organisations disposent de moins de temps pour analyser une faille, évaluer leur exposition, appliquer un correctif ou déployer une mesure compensatoire.

Les catégories technologiques les plus souvent touchées par des vulnérabilités activement exploitées : sur 495 failles connues comme exploitées durant les six premiers mois de 2026, les systèmes de gestion de contenu représentaient près d’un tiers du total.

Les équipements situés en périphérie des réseaux comptaient pour presque 14 %. Les systèmes d’exploitation approchaient 9 %, devant les logiciels serveurs à 8 %. Les produits liés à l’intelligence artificielle représentaient eux-mêmes près de 6 % des vulnérabilités exploitées, signe de l’apparition d’une nouvelle surface d’attaque.

Cette dernière donnée ajoute une dimension supplémentaire au sujet. L’IA n’est plus uniquement un outil susceptible d’aider à découvrir des failles. Les produits qui l’intègrent deviennent également des cibles dont les vulnérabilités peuvent rejoindre les chaînes d’exploitation observées sur le terrain.

Pour le renseignement cyber, l’enjeu central n’est donc pas seulement de compter les failles trouvées par l’IA : il consiste à distinguer rapidement celles qui basculent du signal technique vers une menace opérationnelle. (rapport)